Файл robots.txt напрямую влияет на то, какие разделы сайта поисковые роботы могут обходить. Даже небольшая ошибка в его настройке способна случайно ограничить доступ к важным страницам и помешать их нормальной индексации.
В статье разберём, как проверить robots, какие директивы используются в файле, где чаще всего возникают ошибки и как убедиться, что настройки robots не препятствуют SEO-продвижению сайта.
Что такое robots.txt и зачем он нужен
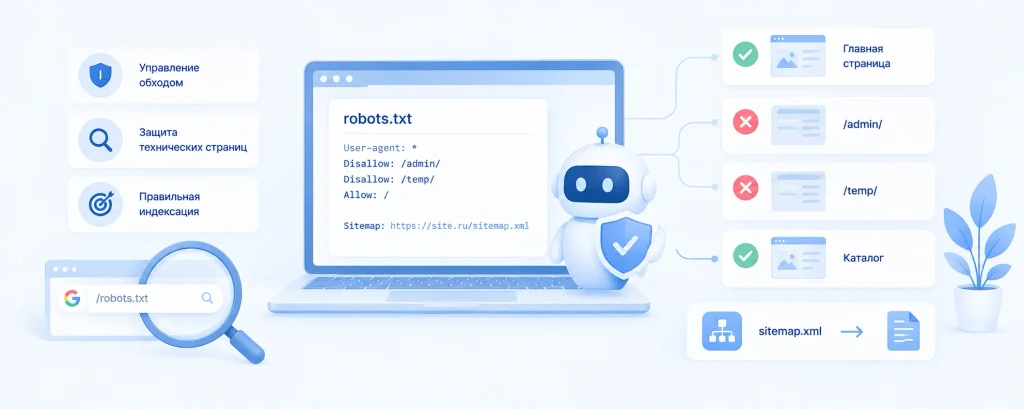
Robots.txt — это специальный текстовый файл, который размещается в корневой директории сайта и содержит инструкции для поисковых роботов. С его помощью можно указать, какие разделы и файлы разрешено обходить, а к каким доступ для роботов следует ограничить.
Файл нужен прежде всего для управления обходом сайта. Например, в нём можно закрыть от посещения поисковыми роботами технические страницы, служебные разделы или другие URL, которые не должны участвовать в поисковой выдаче. При этом важные страницы сайта, наоборот, должны оставаться доступными для обхода.
Правильные настройки robots помогают поисковым системам эффективнее сканировать ресурс и сосредоточиться на действительно важных страницах. Поэтому перед SEO-продвижением стоит убедиться, что файл не блокирует нужные разделы и не содержит лишних ограничений.
Важно учитывать, что robots.txt не является универсальным способом запретить страницу к индексации. Он управляет прежде всего обходом URL, поэтому для разных задач могут использоваться и другие SEO-инструменты, например noindex или авторизация.
Где находится robots.txt и как его проверить
Файл robots.txt обычно находится в корневой директории сайта и доступен по адресу https://site.ru/robots.txt. Чтобы проверить файл robots, не обязательно иметь доступ к админ-панели — достаточно открыть его в браузере.
Проверку можно провести по следующему алгоритму:
- Откройте файл. В адресной строке браузера добавьте
/robots.txtпосле домена сайта и убедитесь, что файл загружается без ошибки. - Посмотрите содержимое. Проверьте, какие директивы указаны для поисковых роботов и какие разделы сайта ограничены от обхода.
- Найдите важные URL. Убедитесь, что страницы, которые должны участвовать в поисковой выдаче, не попали под запрещающие правила.
- Проверьте синтаксис. Обратите внимание на написание директив, пути к каталогам и отсутствие случайных символов или некорректных правил.
- Сопоставьте файл со структурой сайта. Если структура или URL недавно изменились, старые правила могут блокировать уже нужные разделы.
- Проверьте карту сайта. Если в robots.txt указана ссылка на
sitemap.xml, она должна вести на существующий и доступный файл.
Такая проверка позволяет быстро обнаружить потенциальные ошибки robots txt ещё до начала детального технического аудита и убедиться, что файл не ограничивает обход важных страниц.
Как правильно настроить robots.txt
Настройка robots.txt начинается с определения того, какие страницы поисковым роботам действительно нужно обходить. Не стоит закрывать целые разделы только потому, что они кажутся техническими: перед добавлением правила важно понимать, на какие URL оно повлияет.
Основные директивы файла:
User-agent— определяет, для какого поискового робота действуют следующие правила. Например, можно задать инструкции для всех роботов или отдельно для конкретного поисковика.Disallow— запрещает роботам обход указанных страниц или разделов. С его помощью обычно ограничивают доступ к служебным каталогам и URL, которые не имеют ценности для поиска.Allow— позволяет открыть для обхода отдельные страницы или файлы внутри раздела, который частично закрыт правиломDisallow.Sitemap— указывает поисковым системам адрес XML-карты сайта. В файле лучше использовать полный URL актуальногоsitemap.xml.
При составлении правил важно избегать слишком широких запретов. Например, случайно закрытый каталог может содержать не только технические страницы, но и важные разделы, которые должны индексироваться. После внесения изменений стоит ещё раз проверить файл и убедиться, что нужные URL остаются доступными для поисковых роботов.
Как понять, что robots.txt мешает индексации сайта
Не всегда проблему с индексацией удаётся заметить сразу. Сайт может продолжать работать для пользователей, но отдельные страницы при этом окажутся недоступны поисковым роботам из-за ограничений в файле.
Обратите внимание на несколько признаков:
- Важные страницы не появляются в поиске. Если новые или уже существующие страницы долго не индексируются, стоит проверить, не запрещён ли их обход.
- Количество страниц в поиске неожиданно снизилось. Резкое изменение числа проиндексированных URL после правок файла может указывать на слишком строгие ограничения.
- Закрыт целый раздел сайта. Иногда одна директива блокирует сразу большое количество страниц. Особенно внимательно стоит проверять правила, распространяющиеся на каталоги и разделы.
- Изменения в файле совпали с падением трафика. Если после обновления robots.txt снизилась посещаемость из органического поиска, стоит сопоставить изменения с тем, какие URL стали недоступны для обхода.
- Поисковые роботы не могут получить доступ к нужным ресурсам. Блокировка отдельных CSS, JavaScript или изображений в некоторых случаях может мешать поисковой системе корректно оценивать страницу.
Если обнаружен хотя бы один из таких признаков, необходимо сопоставить правила файла со страницами, которые должны участвовать в поисковой выдаче. Особое внимание стоит уделить изменениям, внесённым незадолго до появления проблем с индексацией.